
Fato verificado
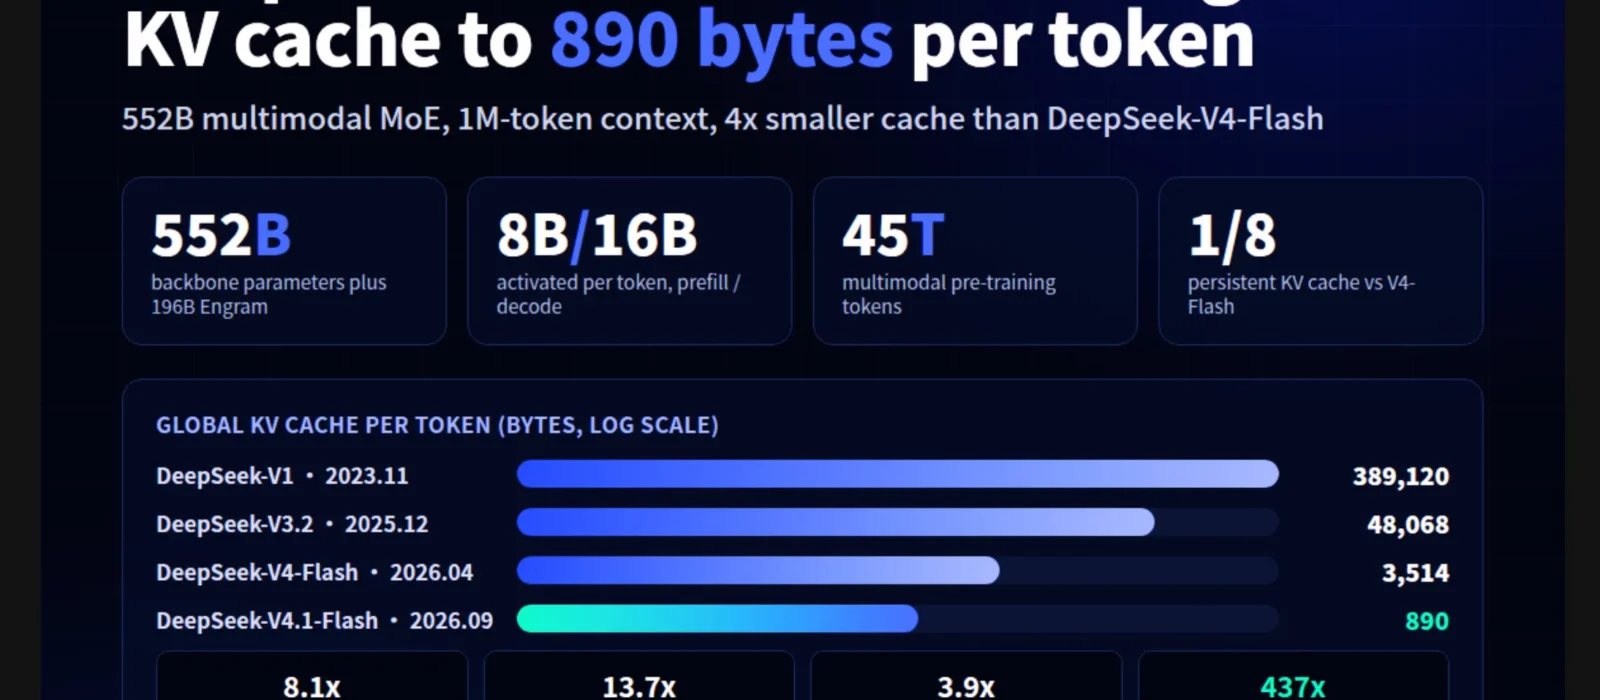
A chinesa DeepSeek liberou o modelo DeepSeek-V4.1-Flash com licença MIT e pesos disponíveis no Hugging Face, conforme o MarkTechPost em 10 de setembro de 2026. A arquitetura declarada tem 552 bilhões de parâmetros no backbone mais 196 bilhões em módulos Engram, ativando 8 bilhões de parâmetros por token no preenchimento e 16 bilhões na geração, com janela de contexto de 1 milhão de tokens. A empresa afirma reduzir o cache KV para cerca de 890 bytes por token, aproximadamente um quarto do modelo anterior. Nos testes divulgados pela própria equipe, o modelo marcou 90,6 no Terminal-Bench 2.1 e 74,2 no DeepSWE v1.1, acima dos resultados citados para Opus-5 (89,1 e 74,0) e GPT-5.6 Sol (88,8 e 73,0). A publicação IntelligentLiving relata preços fora de pico de US$ 0,15 por milhão de tokens de entrada não cacheada e US$ 0,60 por milhão de tokens de saída, além da aposentadoria do V4 Flash e do início da retirada escalonada do V4 Pro a partir de 14 de setembro.
Por que importa
Quando o custo por tarefa de IA cai de forma relevante, automações que não fechavam a conta em uma empresa média passam a fechar.
Leitura estratégica
Minha leitura é que a novidade aqui é economia, não inteligência: o ganho central declarado é de eficiência de memória e preço, o que importa justamente para agentes que rodam por horas. É preciso separar o que está verificado do que não está — os benchmarks são reportados pela própria equipe do modelo e ainda sem validação independente; o que está confirmado é a publicação dos pesos sob licença MIT.
Risco real
Adotar um modelo por preço, sem avaliar onde os dados são processados e sem teste próprio de qualidade, troca economia de curto prazo por risco de conformidade.
Possibilidade prática
Quem já usa IA em processo repetitivo pode medir hoje o custo por tarefa e comparar alternativas em um teste controlado, com dados não sensíveis, antes de migrar qualquer operação relevante.
Fonte: MarkTechPost; IntelligentLiving. Link original